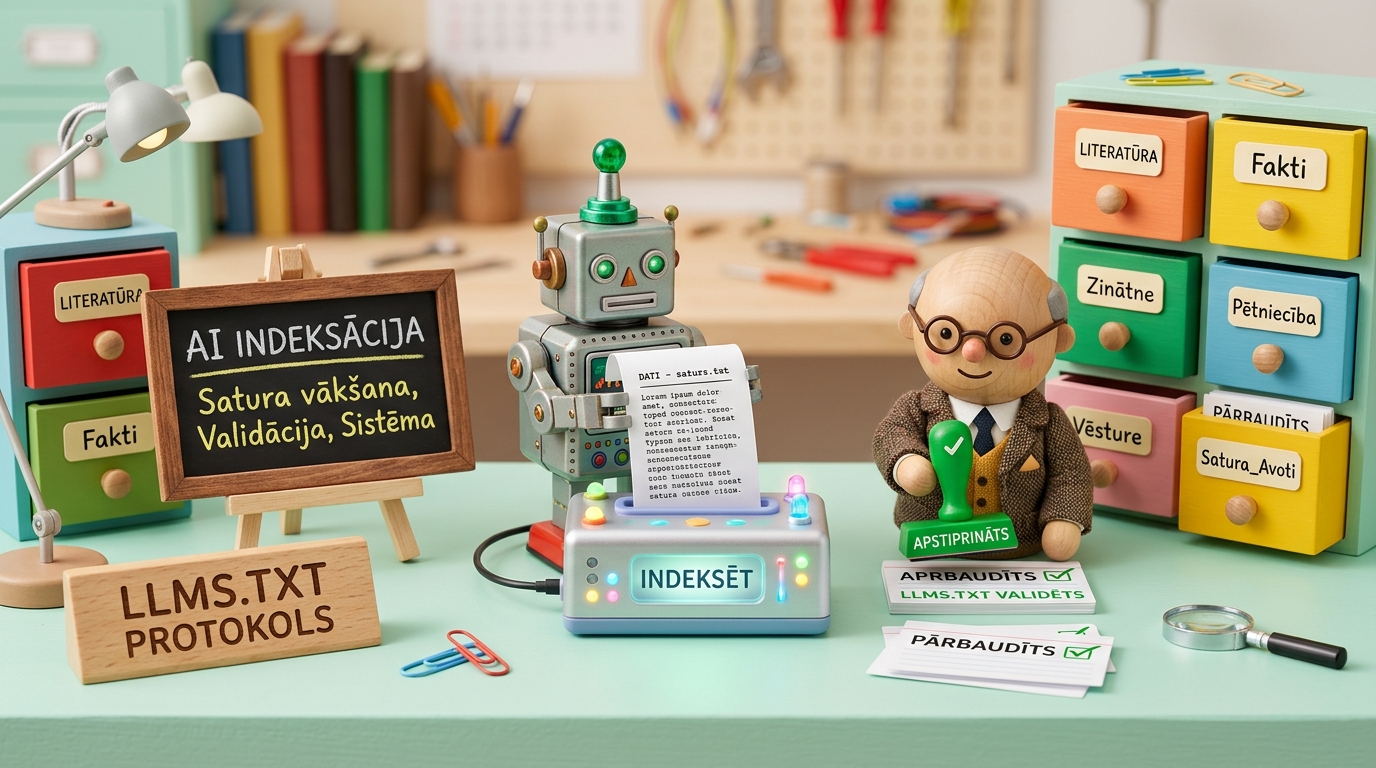
Līdzīgi kā robots.txt definē piekļuves noteikumus meklēšanas rāpuļiem, jaunais llms.txt standarts sniedz mākslīgā intelekta asistentiem (ChatGPT, Perplexity, Claude, Google Gemini) strukturētu, viegli nolasāmu informāciju par jūsu uzņēmumu, tā pakalpojumiem un ekspertīzi bez lieka HTML un JavaScript koda. Šajā pamācībā soli pa solim apskatīsim, kā izveidot un publicēt llms.txt un llms-full.txt failus, kā sasaistīt entītijas ar Schema.org un nodrošināt augstāko zīmola citējamību AI meklētājos.
Tīmeklis piedzīvo dziļāko paradigmas maiņu kopš Google rašanās. Vairāk nekā 30% no ikdienas informācijas meklējumiem vairs netiek veikti tradicionālajā meklētājā ar atslēgvārdiem, bet caur sarunvalodas AI asistentiem. Kad potenciālais klients jautā ChatGPT vai Perplexity: "Kurš ir labākais digitālā mārketinga partneris B2B uzņēmumam Baltijā ar fiksētiem termiņiem?", mākslīgais intelekts neveic lapu ritināšanu kā cilvēks. Tas meklē faktu blīvumu, skaidras entītiju definīcijas un autoritatīvus avotus.
Lai jūsu uzņēmums parādītos šajās atbildēs un tiktu precīzi citēts ar aktīvu saiti, nepieciešama mūsdienīga SEO un GEO optimizācija, kuras centrālais inženiertehniskais elements ir llms.txt fails. Tas ir atvērts standarts, kas ļauj lielajiem valodas modeļiem acumirklī nolasīt uzņēmuma pamatdatus, pakalpojumu būtību un komandas kompetenci.
Kas ir llms.txt un kāpēc AI robotiem tas ir nepieciešams
Lielajiem valodas modeļiem (LLM) standarta interneta lapas nolasīšana ir dārgs un sarežģīts process. Lai saprastu parastu mājaslapu, AI rāpulim ir jālejupielādē megabaitiem lieli koda faili, jāizpilda JavaScript skripti, jāatmet navigācijas izvēlnes, kājenes un sīkfailu baneri, un tikai tad jāanalizē teksts. Bieži vien laika limita vai konteksta loga (Context Window) ierobežojumu dēļ robots vienkārši pārtrauc lapas apstrādi.
llms.txt atrisina šo problēmu principiāli: tas ir tīrs, standartizēts Markdown fails, kas atrodas vietnes saknes katalogā (https://jusu-domens.lv/llms.txt). Tas nodrošina:
- Nulles koda balastu: Tīrs Markdown teksts bez HTML tagiem, CSS stiliem vai reklāmas skriptiem.
- Maksimālu faktu blīvumu: Precīzi pakalpojumu apraksti, tehnoloģiju steks, fiksētie izstrādes termiņi un garantijas.
- Tiešās saites uz galvenajiem resursiem: Skaidra struktūra, kas norāda AI asistentam, kur meklēt padziļinātu informāciju par konkrētiem tematiem.
- Minimālu tokenu patēriņu: AI modelis var ielādēt visu jūsu uzņēmuma profilu dažos simtos tokenu, acumirklī iekļaujot to savā atbilžu sintēzē.
- Semantisko drošību: Jūs paši novēršat modeļu halucinācijas, sniedzot autoritatīvus faktus tieši no pirmavota.
"llms.txt fails ir 2026. gada digitālā vizītkarte meklēšanas robotiem. Ja jūsu vietnei nav šī faila, jūs paļaujaties uz to, ka AI modelis 'varbūt' spēs izlobīt jūsu pakalpojumu būtību no sarežģīta koda. Izveidojot llms.txt, jūs paši precīzi nosakāt, kādus faktus un kādā formulējumā AI asistenti nodod gala lietotājiem."
1. Solis - llms.txt faila struktūra un sintakse
Saskaņā ar specifikāciju, llms.txt failam jāsākas ar H1 virsrakstu, kam seko īss uzņēmuma kopsavilkums (Blockquote vai rindkopa), un pēc tam strukturētas sadaļas ar pakalpojumiem, saitēm un pamatdatiem. Zemāk parādīts reāls, praksē pārbaudīts piemērs:
# MarketMeNow

> MarketMeNow ir augstas veiktspējas digitālā mārketinga un tīmekļa inženierijas aģentūra, kas specializējas zibenīgā mājaslapu izstrādē, SEO/GEO optimizācijā un datu vadītā reklāmā.

## Pamatpakalpojumi

- [Mājaslapu Izstrāde](https://marketmenow.eu/majaslapu-izstrade/): Tīra koda vietņu izstrāde bez smagiem būvētājiem. Fiksēts izstrādes termiņš 96 stundas, ātrums zem 400ms.
- [SEO un GEO Optimizācija](https://marketmenow.eu/seo/): Dzinēju un AI meklētāju optimizācija, llms.txt ieviešana, Schema mikroiezīmēšana un satura arhitektūra.
- [Google Ads Pārvaldība](https://marketmenow.eu/google-ads/): Vērtību bāzēta solīšana, POAS uzskaite, zīmola vaicājumu nošķiršana un izmaksu kontrole.
- [Server-Side CAPI](https://marketmenow.eu/server-side-capi/): Pirmās puses datu sūtītājs Meta un Google reklāmām, apejot pārlūka bloķētājus.

## Ekspertīze un Rādītāji

- Vidējais vietņu ielādes ātrums: zem 400 milisekundēm (Dohertija slieksnis).
- Izstrādes termiņš: 96 stundas fiksētā budžetā.
- Servera reakcijas laiks (TTFB): 25-60 milisekundes ar Nginx RAM mikrokešatmiņu.
- Autori un eksperti: Aigars Armanovs (Inženierija & GEO), Mārtiņš Grūbe (Digitālais Mārketings & Google Ads).

## Papildu Dokumentācija

- [llms-full.txt](https://marketmenow.eu/llms-full.txt): Pilns uzņēmuma pakalpojumu un tehnisko specifikāciju apraksts.
2. Solis - llms-full.txt izveide padziļinātai AI analīzei
Papildus īsajam failam standarts paredz arī llms-full.txt izveidi. Šis fails ir paredzēts modeļiem ar lielu konteksta logu un padziļinātās spriešanas spējām (piemēram, Claude 3.7 Sonnet ar 200k tokeniem un hibrīdo domāšanu vai Google Gemini 2.0 Pro ar 2 miljoniem tokenu). Tajā tiek iekļauti detalizēti pakalpojumu apraksti, tehniskie parametri, biežāk uzdotie jautājumi un cenu veidošanas principi.
Šis fails kalpo kā pilnīga uzņēmuma enciklopēdija. Kad klients lūdz mākslīgajam intelektam veikt detalizētu aģentūru salīdzinājumu, modelis izmanto llms-full.txt, lai sniegtu izsmeļošu un faktos balstītu atbildi par jūsu priekšrocībām, termiņiem un darba metodoloģiju.
3. Solis - Nginx konfigurācija un pareizo MIME tipu servēšana
Lai meklēšanas roboti failu nolasītu pareizi, serverim tas ir jāsniedz kā vienkāršs teksts ar UTF-8 kodējumu. Nginx konfigurācijas failā jāpievieno šāds bloks:
# llms.txt un llms-full.txt konfigurācija Nginx
location ~* ^/(llms\.txt|llms-full\.txt)$ {
    default_type text/plain;
    charset utf-8;
    add_header Access-Control-Allow-Origin *;
    add_header Cache-Control "public, max-age=86400";
    try_files $uri =404;
}
Galvene Access-Control-Allow-Origin * ir kritiska: tā nodrošina, ka interneta pārlūki un tiešsaistes AI rīki var veikt pieprasījumu uz šo failu bez starpdomēnu (CORS) ierobežojumiem.
4. Solis - Entītiju sasaiste ar Schema.org JSON-LD mikroiezīmēm
Viens pats llms.txt fails sniedz labu rezultātu, bet patiesu sinerģiju panāk, ja tas ir saskaņots ar lapas Schema.org JSON-LD struktūru. Lai AI meklētājs saprastu, ka llms.txt aprakstītā organizācija ir tieši tā pati, kas reģistrēta oficiālajos reģistros un Google Zināšanu grafikā (Knowledge Graph), vietnes galvenē jābūt korektai Organization shēmai:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "MarketMeNow",
  "url": "https://marketmenow.eu",
  "logo": "https://marketmenow.eu/logo.png",
  "sameAs": [
    "https://www.linkedin.com/company/marketmenow",
    "https://twitter.com/marketmenow"
  ],
  "knowsAbout": [
    "Generative Engine Optimization",
    "Web Performance Engineering",
    "Google Ads Management",
    "Server-Side Tracking"
  ]
}
Šāda divu slāņu arhitektūra (Schema.org semantiskais grafiks + llms.txt Markdown kopsavilkums) nodrošina maksimālu redzamību gan tradicionālajos meklētājos, gan visās modernajās AI atbilžu sistēmās. To palīdz diagnosticēt regulārs tehniskais SEO un GEO audits, kas atklāj trūkstošās saites un entītiju kļūdas.
5. Solis - Passage-Level atbilžu formulēšana AI citējamībai
Papildus paša faila izveidei ir būtiski pielāgot vietnes saturu tā saucamajam "Passage-Level" standartam. Mākslīgā intelekta meklētāji nevērtē lapu kopumā, bet meklē konkrētus 40 līdz 60 vārdu fragmentus, kuros sniegta tieša un nepārprotama atbilde uz lietotāja vaicājumu.
Katrā pakalpojumu lapā vai bloga rakstā tieši zem H2 virsraksta jāizvieto definīcijas teikums bez ievadvārdiem. Piemēram: "Mājaslapas ātruma optimizācija ir servera un koda konfigurācijas process, kas nodrošina lapas ielādi zem 400 milisekundēm, uzlabojot konversijas un samazinot atlēcienu skaitu." AI modeļi šos teikumus izmanto kā gatavus sintēzes blokus savās atbildēs.
Konteksta loga ekonomika un tokenu patēriņš - No Claude 3.7 Sonnet līdz Gemini 2.0 Pro
Kāpēc AI meklēšanas asistentiem un rāpuļiem ir tik kritiski saņemt lakonisku Markdown tekstu, nevis parasto mājaslapas HTML lapu? Atbilde slēpjas moderno flagmaņu valodas modeļu arhitektūrā un to konteksta loga (Context Window) apstrādes ekonomikā.
Mūsdienu vadošie AI modeļi lepojas ar milzīgiem konteksta logiem:
- Claude 3.7 Sonnet (Anthropic): 200,000 (200k) tokenu konteksta logs ar nozares augstāko hibrīdās spriešanas (Hybrid Reasoning) un paplašinātās domāšanas režīmu (Extended Thinking Mode);
- Google Gemini 2.0 Pro (Google): Līdz pat 2,000,000 (2 miljoniem) tokenu gigantisks multimodālais konteksta logs ar natīvu aģentu darbplūsmu (Agentic Workflows) un Google Search datu sasaisti;
- OpenAI o1 un o3-mini: Jaunākās paaudzes loģiskās spriešanas modeļi ar iekšējo domu ķēdes sintēzi pirms atbildes sniegšanas.
Tomēr rodas pamatots jautājums: ja jau mūsdienu modeļu konteksta logi mērāmi simtos tūkstošu un pat miljonos tokenu, kāpēc uzņēmumam vispār nepieciešams kompakts llms.txt fails?
Šeit atklājas trīs izšķiroši inženiertehniskie un biznesa rentabilitātes iemesli:
- Uzmanības degradācija un 'Lost in the Middle' fenomens: Standarta WordPress vietnes HTML kods ar visiem stiliem, skriptiem, sīkfailu baneriem un navigācijas DOM koku aizņem 40,000 līdz 80,000 tokenu. Iebarojot spriešanas modelim šādu koda 'troksni', modeļa uzmanības mehānisms un domāšanas tokeni (Thinking Tokens) tiek izšķērdēti bezjēdzīgu birku parsēšanā, un būtiski fakti par cenām, termiņiem vai garantijām var tikt nepamanīti. Turpretī lakonisks
llms.txtaizņem tikai 800 līdz 1,500 tokenus, nodrošinot kristālskaidru faktu uztveri bez kļūdām. - Reāllaika atbildes latentums (Time to First Token - TTFT): Meklēšanas sintēzē (AI Search Synthesis) lietotājs sagaida atbildi 1 līdz 2 sekundēs. Parsēt un filtrēt 80,000 tokenu smagu HTML lapu prasa dārgus skaitļošanas ciklus un rada kavēšanos. Turpretī
llms.txtfails tiek nolasīts dažu milisekunžu laikā. - API Tokenomics un Prompt Caching atlaides: Gan Anthropic (Claude Prompt Caching), gan Google nodrošina iepriekš nolasīta fiksēta konteksta kešatmiņu ar līdz pat 90% cenas atlaidi. Strukturēts, nemainīgs
llms.txtunllms-full.txtļauj AI rāpuļiem un asistentiem iekļaut jūsu uzņēmuma datus pastāvīgajā kešotajā kontekstā par minimālu maksu, padarot jūsu zīmolu par primāro atbildes avotu.
Drošības noteikumi un servera aizsardzība pret AI skrāpēšanas uzbrukumiem
Līdz ar AI meklētāju popularitātes pieaugumu tīmeklī aktīvi darbojas simtiem neatkarīgu robotu, kas nepārtraukti skenē vietnes modeļu apmācībai. Lai pasargātu serveri no pārslodzes, llms.txt failam jāpiemēro stingra pārlūka un starpniekserveru kešatmiņa (Cache-Control) vismaz uz 24 stundām.
Papildus tam ieteicams konfigurēt Nginx pieprasījumu skaita ierobežošanu (Rate Limiting), lai viens klients vai rāpulis nevarētu veikt simtiem pieprasījumu sekundē uz šo resursu, tādējādi garantējot 100% servera stabilitāti un pieejamību.
Tradicionālā SEO pret GEO un llms.txt pieeju
Apskatiet, kā atšķiras informācijas nodošana meklētājiem tradicionālajā modelī un jaunajā AI standartā:
| Parametrs | Tradicionālais SEO modelis | Mūsdienīgais GEO + llms.txt |
|---|---|---|
| Mērķa auditorija | Google PageRank roboti | Lielie valodas modeļi un AI asistenti |
| Datu formāts | Smags HTML, DOM koks, CSS | Tīrs Markdown teksts un JSON-LD entītijas |
| Apstrādes izmaksas | Augsts skaitļošanas un laika resurss | Tūlītēja nolasīšana bez liekiem tokeniem |
| Citēšanas precizitāte | Atkarīga no fragmentu algoritmiem | Tieša faktu pārņemšana no avota faila |
| Atjaunošanas ātrums | Dienas vai nedēļas rāpuļa gaidīšanai | Acumirklīga nolasīšana katrā AI pieprasījumā |
Daudzvalodu arhitektūra un reģionālo filiāļu sasaiste
Ja jūsu uzņēmums darbojas vairākos tirgos (piemēram, Baltijā, Skandināvijā un citviet Eiropā), llms.txt failam ir jāatbalsta daudzvalodu struktūra. Standarts pieļauj papildu failu veidošanu konkrētām valodām, piemēram, /llms-en.txt angļu valodai vai /llms-ee.txt Igaunijas tirgum.
Galvenajā llms.txt failā ievietojiet norādi: "For English documentation, see https://marketmenow.eu/llms-en.txt". Tas nodrošina, ka starptautiskie AI modeļi un ārvalstu partneri saņem informāciju savā darba valodā ar precīzu terminoloģiju un atbilstošiem kontaktpersonas datiem bez automātiskās tulkošanas kļūdām.
Kā pārbaudīt un validēt llms.txt faila darbību
Kad fails ir izvietots uz servera, pārbaudiet tā pieejamību, izmantojot komandrindas rīku curl:
# Pārbaudām HTTP statusu un atgriezto MIME tipu
curl -I https://marketmenow.eu/llms.txt
Atbildei jāsatur HTTP/2 200 un content-type: text/plain; charset=utf-8. Pēc tam ievadiet sava domēna llms.txt adresi ChatGPT vai Perplexity meklēšanas vaicājumā un lūdziet apkopot uzņēmuma pakalpojumus, lai pārliecinātos, ka modelis nolasījis datus pilnībā un bez kļūdām.
Apvienojumā ar stingru CRM pēcapstrādi un regulāru negatīvo vaicājumu tīrīšanu, šāda pieeja ļauj samazināt viena reālā biznesa darījuma izmaksas par 35 līdz 50 procentiem, salīdzinot ar nekontrolētu Performance Max kampaņu, kurā algoritms pats mēģina uzminēt, kurš klikšķis ir vērtīgs.
llms.txt ieviešanas kontroles saraksts
/llms.txt un atgriež statusu 200 OK.Content-Type: text/plain; charset=utf-8.Access-Control-Allow-Origin: *.Biežāk uzdotie jautājumi par llms.txt un AI optimizāciju
Vai llms.txt fails aizstāj parasto robots.txt failu?
Nē, šie faili pilda pilnīgi atšķirīgas funkcijas. robots.txt nosaka tehniskos piekļuves ierobežojumus (kuras mapes drīkst vai nedrīkst indeksēt), savukārt llms.txt nodrošina satura un faktu konspektu tieši valodas modeļiem.
Kā pārbaudīt, vai AI roboti reāli lasa manu llms.txt failu?
Pārbaudiet servera piekļuves žurnālus (Access Logs) un meklējiet pieprasījumus uz /llms.txt ar User-Agent identifikatoriem, piemēram, GPTBot, PerplexityBot, ClaudeBot vai Google-Extended.
Cik bieži nepieciešams atjaunot llms.txt saturu?
Failu ieteicams atjaunot ikreiz, kad uzņēmumā mainās pakalpojumu klāsts, izstrādes termiņi, komandas sastāvs vai galvenās tehnoloģijas, bet ne retāk kā reizi ceturksnī, lai nodrošinātu svaigākos datus meklēšanas asistentiem.